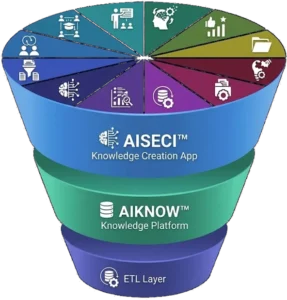
9つの技術は独立した部品ではなく、一つの流れの上に並んでいます。

業務で使われる文書は、文章だけでできていません。図面、表、グラフ、数式、注記が同じ紙面に混在し、意味は配置と対応関係の中にあります。文字列として取り出すだけでは、この意味が落ちます。
ページを画像として捉え、レイアウト構造と要素どうしの対応を解析。表はセル単位、数式は記号の関係として取り出し、どのページのどこから取り出したかを保持したまま構造化します。

日本語の手書きは、文字種の多さ、続け字、崩し方の個人差により、従来のOCRでは実用精度に届かない領域でした。帳票の記入欄からはみ出した文字、かすれ、訂正線が加わればなおさらです。
文字を一つずつ認識するのではなく、VLMで前後の文脈ごと読み取ります。帳票のレイアウトと記入欄の意味を同時に理解するため、崩れた文字も周囲から復元できます。処理速度は、実運用の処理量に耐える水準で設計しています。

音声は、文字起こしをしただけでは使えません。誰が、どの話題について、どんな温度で話したのか。知識として引ける状態にするには、会話の流れそのものを構造にする必要があります。
話者分離、話題の切り替わり点の検出、要約、感情の推定までを一続きで処理し、通話や会議を検索できる単位へ分解します。

検索が届かないのは、言葉が一致しないときです。同じことを指す別の言い方、前提となる知識、代替できる技能。これらは文字列の比較では見つかりません。
概念どうしの関係をグラフとして持ち、類似・上下関係・転用可能性まで表現します。AIKNOW Matching の Skill Ontology は、この考え方を人材領域に適用したもので、要求スキルを直接持たない候補者まで評価の対象に含められます。

OKF は、2026年6月に Google Cloud が公開したオープン仕様です。組織の知識を markdown と YAML frontmatter だけで表現し、専用のデータベースやSDK、特定のクラウドを必要としません。ファイルどうしがリンクで結ばれ、そのままナレッジグラフになります。
特定のベンダーに閉じた形式で知識を預かることは、お客様の資産を人質に取ることと同じです。いつでも持ち出せる形で持つことを、Technicaは設計方針としています。

「何であるか」の知識と、「どう進めるか」の知識は、性質が異なります。前者は文書に書かれますが、後者は人の頭の中と、実際の作業の順序の中にあります。
両者を分けて扱うことで、手順は再現でき、内容は更新できます。AISECI の暗黙知から形式知への変換は、この区別を前提に設計されています。

一度の検索で足りる質問は、実務にはほとんどありません。調べ、足りない部分に気づき、条件を変えて調べ直す。人がやっている過程を省くと、答えは浅くなります。
検索・評価・再検索を自律的に繰り返し、根拠が揃った時点で回答を組み立てます。出典を保持するため、どの文書のどこから導いたかを確認できます。

導入時点の精度は、出発点にすぎません。現場で使われる中で生まれる修正、例外、判断の理由こそ、その組織に固有の知識です。
解いた結果と、そこで得られた新しい知見を同じ流れの中で取り込み、次の問いに反映します。運用が学習を兼ねるため、対応できる範囲は時間とともに広がります。

機密情報を扱う現場では、外部APIに送れないという制約が先に立ちます。自社環境で動かすには、モデルを載せられる大きさに収め、その業務の言葉に合わせる必要があります。
量子化による軽量化と、領域データによる調整を組み合わせ、オンプレミス環境でも応答速度を実用水準に保ちます。
評価用の検証環境、ベンチマークの条件、オンプレミス構成の要件。
導入前に確認したい技術的な論点があれば、ご相談ください。