Challenges

文字起こししただけで、
音声データを活用できていますか?

従来の音声認識は、「音を文字にする」ことを目的として設計されています。

しかし、実際の会話には、ノイズ、言い淀み、同音異義語、専門用語、固有名詞、数字、複数言語の混在など、

多くの曖昧さがあります。

01
文脈が失われ、誤認識が起きる
短い音声単位だけでは会話全体の意味を捉えられず、同音異義語や専門用語を誤って認識することがあります。
02
文字起こし後の加工に手間がかかる
話者の識別、フィラー除去、文章整形、重要箇所の抽出など、分析前に多くの前処理が必要です。
03
そのままAIに利用できない
個人情報や長大なトランスクリプトを含むため、RAGや生成AIへ直接利用することが困難です。

Speech Intelligence

「音 → 文字」から、
「音 → 意味 → 知識」へ

Conventional ASR

従来型ASR

  • Audio
  • Speech-to-Text

音声を文字へ変換することがゴール。

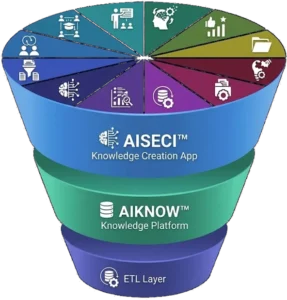
AIKNOW Voice

AIKNOW Voice

  • Audio
  • Transcription
  • Context Understanding
  • Semantic Processing
  • PII Protection
  • Knowledge

文字起こしは、ゴールではありません。

AIKNOW Voiceは会話の文脈と意味を理解し、音声から企業が利用できる「Knowledge」を生成します。

Speech Recognition から、Speech Intelligence へ。

Core Capabilities

AIで使うための音声データを、最初からつくる

Context-Aware Transcription
会話全体の文脈から認識結果を補正
長い会話の文脈を保持し、意味的な推論によって同音異義語や曖昧な発話を補正。GenAIを活用し、読みやすく意味の通るトランスクリプトを生成します。
Domain & Multilingual
専門用語・固有名詞・英語混在にも対応
専門用語や固有名詞に加え、日本語の会話中に英語が現れるコードスイッチングや、電話番号などの数値データにも対応します。
Speaker & Audio Processing
会話を、分析しやすいデータへ
話者を識別して各発話を分離。「えー」「あのー」などのフィラーや不要なノイズを処理し、読みやすい会話データへ整えます。
PII Protection
個人情報を自動検出・マスキング
住所、電話番号、クレジットカード番号などの個人情報を処理パイプライン上で検出・マスキングし、安全な社内利用を支援します。
Semantic Chunking
「長さ」ではなく「意味」で会話を分割
固定文字数ではなく、話題、意味、重要な発言のまとまりに基づいてトランスクリプトを自動分割します。
AI-Ready Knowledge
RAG・Knowledge Graph・会話分析へそのまま活用
整形・構造化された音声データを、RAG、Knowledge Graph、会話分析、AI学習データなどへ接続できます。

Use Cases

企業に蓄積された「会話」を、ナレッジへ

Call Center Intelligence
コールセンター
顧客との通話を文字起こし・構造化し、問い合わせ内容、クレーム、対応プロセス、オペレーター応対などの分析に活用。
Meeting Intelligence
会議・プロジェクト
会議内容を記録するだけでなく、重要な議論、Action Item、担当者、期限などを抽出し、Project Knowledgeとして蓄積。
Compliance
コンプライアンス・監査
応対内容を分析し、規定違反や誤案内の確認を支援。PIIを保護しながら内部レビューや監査へ利用できます。
Enterprise Knowledge
音声ナレッジ基盤
通話、会議、サポート履歴など、これまで検索・再利用が難しかった音声データをRAGやKnowledge Graphへ統合し、企業のKnowledge Assetへ変換します。

From Voice to Knowledge

音声は、保存するデータから、
使えるナレッジへ。

これまで活用できなかった企業の音声データを、
AIが理解し、検索し、分析し、再利用できるKnowledgeへ。